Criar um agente nunca foi tão fácil. Qualquer pessoa com uma tarde livre e uma ferramenta de vibe coding consegue criar um. (Sem julgamentos. Já lançamos coisas mais estranhas numa sexta-feira.) Mas fazer esse agente valer a pena usar não ficou nada mais fácil.
O Gartner estima o custo dessa lacuna: US$ 376,3 bilhões em gastos com software de agentes de IA somente em 2027, com mais de 40% desses projetos provavelmente cancelados — porque ninguém conseguiu provar que o agente estava funcionando.
Esse é exatamente o problema que nos propusemos a resolver há 18 meses, quando criamos o Agent Analytics. Nosso objetivo era ajudar os clientes a responder a uma pergunta: este agente está realmente ajudando as pessoas que o utilizam? Após mais de 47 milhões de conversas com agentes, continuávamos ouvindo a mesma coisa: os agentes estão passando nas verificações de avaliação, mas não estão realmente ajudando se não sabem o que o usuário está tentando alcançar. Esse é o problema que o Pendo Agent Toolkit foi criado para resolver, e por isso estamos unindo os dois como Pendo for Agents hoje.
Capítulo um: Agent Analytics e o que 500 empresas nos ensinaram
Quando as primeiras empresas começaram a marcar agentes dentro do Pendo, todas elas tinham um gerente de produto de IA fazendo uma pergunta que não tinha nada a ver com tempo de atividade: o agente estava realmente ajudando as pessoas que o utilizavam?
Elas tinham contagens de sessões e gastos com tokens da ferramenta de observabilidade voltada para desenvolvedores que a engenharia havia instalado. Nada disso dizia aos PMs se um piloto de agente estava pronto para avançar para o beta, muito menos se o agente poderia se tornar um produto gerador de receita.
Por isso, criamos o Agent Analytics para responder à pergunta que as ferramentas de observabilidade voltadas para desenvolvedores não conseguem responder: os usuários estão obtendo valor do meu agente? E depois de ajudar ~500 empresas a criar, implantar e escalar agentes, continuamos vendo as mesmas quatro lições, repetidamente.
1. A retenção decide se um agente avança para a próxima etapa, não o uptime. Um agente pode ter logs limpos e passar em todas as verificações de avaliação e ainda não estar pronto para escalar. Quando Ticketmaster decidiu se o agente estava pronto para sair de um piloto limitado, os números que trouxeram confiança foram retenção e rage prompts — não um atestado de saúde da engenharia.
2. Os sinais mais importantes geralmente não são reportados. Um joinha negativo só vem de alguém que se dá ao trabalho de fornecer feedback, e isso é apenas uma fração das pessoas que estão realmente frustradas.
O restante aparece como comportamento no aplicativo (como prompts de raiva e abandono). Nada disso é capturado, porque eles registram o que o usuário digitou, não o que aconteceu depois.

3. Os PMs devem definir o sucesso por conta própria, não apenas aguardar o sistema encontrá-lo. O sucesso nem sempre parece uma compra concluída. Às vezes, o sucesso significa que o usuário obteve a resposta específica que procurava, dentro da conversa com o agente. É por isso que criamos as Custom Success Metrics e demos a você a capacidade de criar seus próprios casos de uso e problemas: cada agente resolve problemas diferentes, e você deve poder medir o que é importante para você.
4. O Agent Analytics se torna mais útil quanto mais próximo ele estiver do seu código. Algumas equipes já estão usando o conector MCP para Agent Analytics para criar loops automatizados: o Agent Analytics sinaliza o problema, os dados fluem para o ambiente de engenharia e a correção é definida sem que ninguém precise trocar de ferramenta. É o mesmo loop que nossa própria equipe executa no Leo, onde gerou um aumento de 61% nos visitantes recorrentes e uma queda de 67% na taxa de problemas nos últimos 60 dias.
O que o Agent Analytics nos mostrou a seguir
Mesmo após esses aprendizados, descobrimos outro problema: um agente zumbi. Esses agentes estão tecnicamente funcionando — respondendo a prompts e passando em todas as verificações de avaliação — mas não têm nenhuma noção de com quem estão realmente falando. O nome pegou.
Se você abre um agente no seu aplicativo favorito, espera que ele te conheça. Ninguém quer explicar o que acabou de tentar e não conseguiu fazer, ou por que está recorrendo ao agente para obter ajuda. Por isso, criamos algo para dar aos agentes exatamente isso: o Agent Toolkit, a outra metade do Pendo for Agents.
Capítulo dois: apresentando o Agent Toolkit, o contexto que transforma um chatbot em um aliado
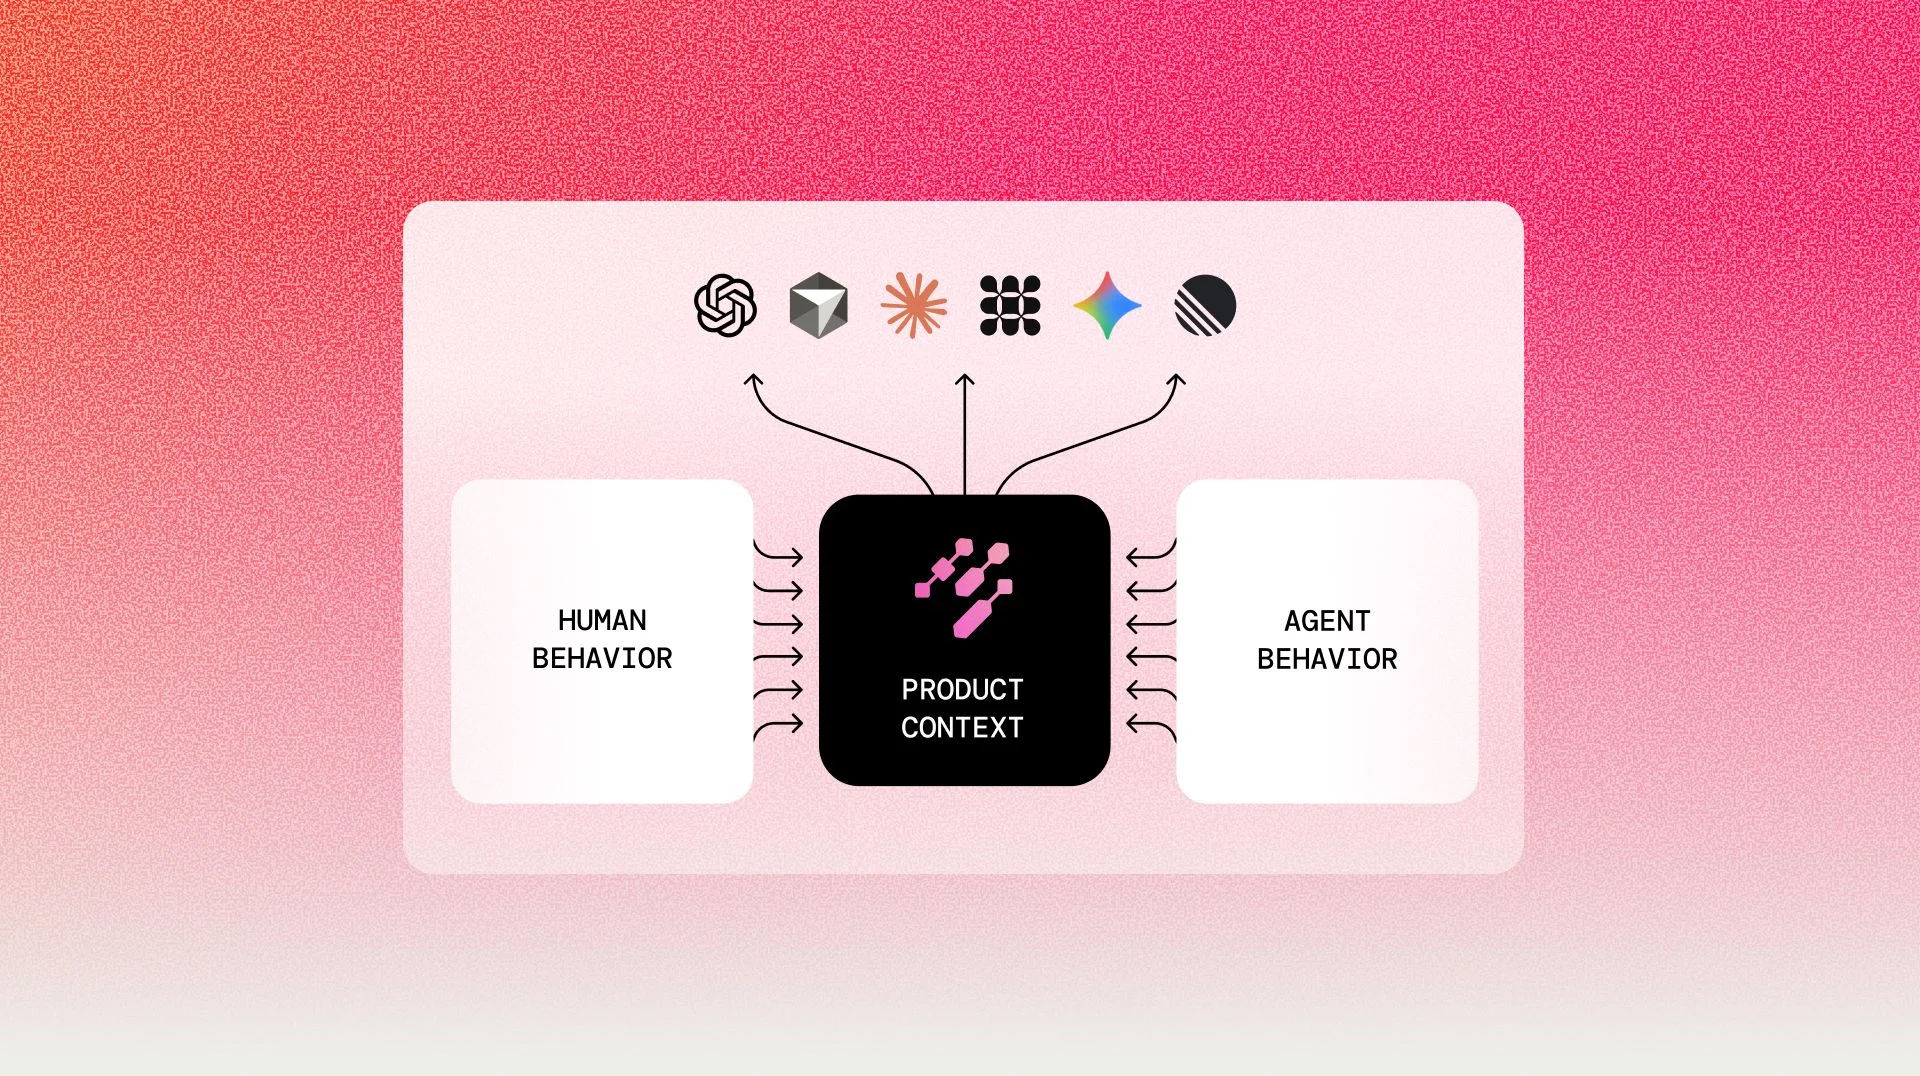
Agent Toolkit fornece a qualquer agente o contexto de produto e usuário que o Pendo já captura, entregue ao agente em tempo real:
- Contexto da sessão: um registro em tempo real do que alguém fez no seu produto, para que o agente já conheça esse histórico.
- Gatilhos de frustração: cliques raivosos, cliques sem resposta, retornos e erros, enviados diretamente ao agente para que ele possa intervir antes que alguém abra um chamado.
- Lembretes de fluxo de trabalho: lembra exatamente onde a pessoa parou caso ela interrompa um processo específico no meio do caminho.
- Exibição de guias: indica o passo a passo, a dica ou o tutorial exato que resolve o problema em que a pessoa está travada, em vez de o agente explicar tudo do zero ou enviá-la para um longo artigo de ajuda.

Esta é a solução real para um agente zumbi. Não um modelo melhor. Não um prompt de sistema mais longo. Contexto. Funciona independentemente de o seu agente ser uma ferramenta de terceiros como Fin, Sierra, Zendesk ou Decagon, ou algo que sua equipe criou do zero.
Teachable vivenciou isso em primeira mão. O agente de suporte deles, desenvolvido com o Fin da Intercom, não sabia de qual página o usuário havia saído nem quantas vezes ele havia clicado no mesmo botão com defeito antes de abrir um chat — um agente zumbi clássico. Assim que o Pendo começou a fornecer esse contexto ao Fin em tempo real, o agente conseguia iniciar a conversa com algo específico: "Parece que você encontrou alguma dificuldade ao ajustar suas configurações. O que você estava tentando mudar?"
O engajamento com mensagens proativas aumentou 200%. 86% dessas conversas foram resolvidas sem escalonamento para um humano, mantendo uma pontuação de CX de 4 de 5 estrelas. O melhor de tudo: 91% nunca precisaram de um humano.
Primeiros passos com o Pendo for Agents: menos zumbi. Mais defensor.
Hoje, o Agent Analytics e o Agent Toolkit estão sob o mesmo teto: o Pendo for Agents, criado para transformar qualquer agente — desenvolvido internamente ou adquirido — no melhor defensor do cliente, em vez de mais um zumbi na pilha. O Agent Analytics responde se um agente está ajudando. O Agent Toolkit o torna melhor em ajudar, antes mesmo de o usuário entrar no chat. Uma metade comprova o valor; a outra metade o entrega mais rápido.

Se você gerencia suporte ou TI, é assim que seus agentes param de reagir a tickets e liberam sua equipe para as conversas que realmente precisam de um humano.
Se você é responsável pelo roadmap, é assim que você finalmente sabe o que seu agente deve fazer a seguir.
Se você tem um assistente no aplicativo, um agente de suporte ao cliente ou algo desenvolvido pela sua própria equipe, solicite uma demonstração para ver o que conversas proativas e contextuais fazem com sua taxa de resolução.
Já usa o Pendo? Comece a usar o Agent Toolkit gratuitamente durante o beta aberto. Basta acessar sua plataforma Pendo e ativar o Agent Toolkit.