Einen Agenten zu entwickeln war noch nie so einfach. Jeder mit einem freien Nachmittag und einem Vibe-Coding-Tool kann einen bauen. (Wir urteilen nicht. Wir haben an einem Freitag schon Seltsameres veröffentlicht.) Aber diesen Agenten wirklich nützlich zu machen, ist nicht einfacher geworden.
Gartner schätzt die Kosten dieser Lücke: allein 376,3 Milliarden US-Dollar an Ausgaben für KI-Agenten-Software im Jahr 2027, wobei mehr als 40 % dieser Projekte wahrscheinlich abgebrochen werden – weil niemand nachweisen konnte, dass der Agent funktionierte.
Genau dieses Problem haben wir uns vor 18 Monaten vorgenommen zu lösen, als wir Agent Analyticsentwickelt haben. Unser Ziel war es, Kunden dabei zu helfen, eine Frage zu beantworten: Hilft dieser Agent den Menschen, die ihn nutzen, wirklich? Nach mehr als 47 Millionen Agent-Gesprächen hörten wir immer wieder dasselbe: Agenten bestehen Evaluierungsprüfungen, helfen aber nicht wirklich, wenn sie nicht wissen, was der Nutzer erreichen möchte. Das ist das Problem, für das Pendo Agent Toolkit entwickelt wurde – und der Grund, warum wir beides heute als Pendo for Agents zusammenführen.
Kapitel eins: Agent Analytics und was uns 500 Unternehmen gelehrt haben
Als die ersten Unternehmen damit begannen, Agenten in Pendo zu taggen, hatte jedes von ihnen einen KI-Produktmanager, der eine Frage stellte, die nichts mit der Betriebszeit zu tun hatte: Half der Agent tatsächlich den Menschen, die ihn nutzten?
Sie hatten Sitzungsanzahlen und Token-Ausgaben aus dem jeweiligen entwicklerzentrierten Observability-Tool, das das Engineering-Team installiert hatte. Nichts davon verriet PMs, ob ein Agent-Pilot bereit war, in die Beta-Phase zu wechseln – geschweige denn, ob der Agent zu einem umsatzgenerierenden Produkt werden könnte.
Deshalb haben wir Agent Analytics entwickelt, um die Frage zu beantworten, die entwicklerzentrierte Observability-Tools nicht beantworten können: Erhalten Nutzer einen Mehrwert durch meinen Agenten? Und nachdem wir ~500 Unternehmen beim Aufbau, der Bereitstellung und der Skalierung von Agenten unterstützt haben, haben wir immer wieder dieselben vier Erkenntnisse gesehen, immer und immer wieder.
1. Die Verbleibsrate entscheidet darüber, ob ein Agent in die nächste Phase übergeht – nicht die Betriebszeit. Ein Agent kann saubere Logs haben und jeden Evaluierungscheck bestehen und trotzdem noch nicht bereit sein, zu skalieren. Als Ticketmaster entschied, ob ihr Agent bereit war, einen eingeschränkten Piloten zu verlassen, waren die Zahlen, die ihnen Sicherheit gaben, Verbleibsrate und Rage-Prompts – und kein einwandfreies Gesundheitszeugnis vom Engineering-Team.
2. Die wichtigsten Signale werden meist nicht gemeldet. Ein Daumen-runter kommt nur von jemandem, der sich die Zeit nimmt, Feedback zu geben – und das ist nur ein Bruchteil der Menschen, die tatsächlich frustriert sind.
Der Rest zeigt sich als In-App-Verhalten (wie wiederholtes Nachfragen aus Frustration und Abbrüche). Nichts davon wird erfasst, weil diese Tools aufzeichnen, was ein Nutzer eingegeben hat – nicht, was danach passiert ist.

3. PMs sollten Erfolg selbst definieren und nicht einfach darauf warten, dass das System ihn erkennt. Erfolg sieht nicht immer wie ein abgeschlossener Kauf aus. Manchmal bedeutet Erfolg, dass der Nutzer die gesuchte Antwort direkt im Agent-Gespräch erhalten hat. Deshalb haben wir Custom Success Metrics entwickelt und Ihnen die Möglichkeit gegeben, eigene Use Cases und Issues zu erstellen: Jeder Agent löst andere Probleme, und Sie sollten messen können, was für Sie wichtig ist.
4. Agent Analytics wird umso nützlicher, je näher es an Ihrem Code liegt. Einige Teams nutzen bereits den MCP-Connector für Agent Analytics , um automatisierte Schleifen aufzubauen: Agent Analytics meldet das Problem, die Daten fließen in die Entwicklungsumgebung, und die Lösung wird erarbeitet, ohne dass jemand das Tool wechseln muss. Es ist dieselbe Schleife, die unser eigenes Team mit Leo betreibt, wo es hat zu einem Anstieg der wiederkehrenden Besucher um 61 % und einem Rückgang der Problemrate um 67 % geführt in den letzten 60 Tagen.
Was Agent Analytics uns als Nächstes zeigte
Selbst nach diesen Erkenntnissen stießen wir auf ein weiteres Problem: einen Zombie-Agent. Diese Agenten funktionieren technisch einwandfrei – sie beantworten Anfragen und bestehen jeden Evaluierungscheck –, haben aber keinerlei Vorstellung davon, mit wem sie eigentlich sprechen. Der Name blieb hängen.
Wenn Sie einen Agenten in Ihrer Lieblingsapp öffnen, erwarten Sie, dass er Sie kennt. Niemand möchte erklären, was er gerade versucht hat und gescheitert ist, oder warum er sich an den Agenten um Hilfe wendet. Deshalb haben wir etwas entwickelt, das Agenten genau das gibt: Agent Toolkit – die andere Hälfte von Pendo for Agents.
Kapitel zwei: Einführung von Agent Toolkit – der Kontext, der einen Chatbot zu einem Fürsprecher
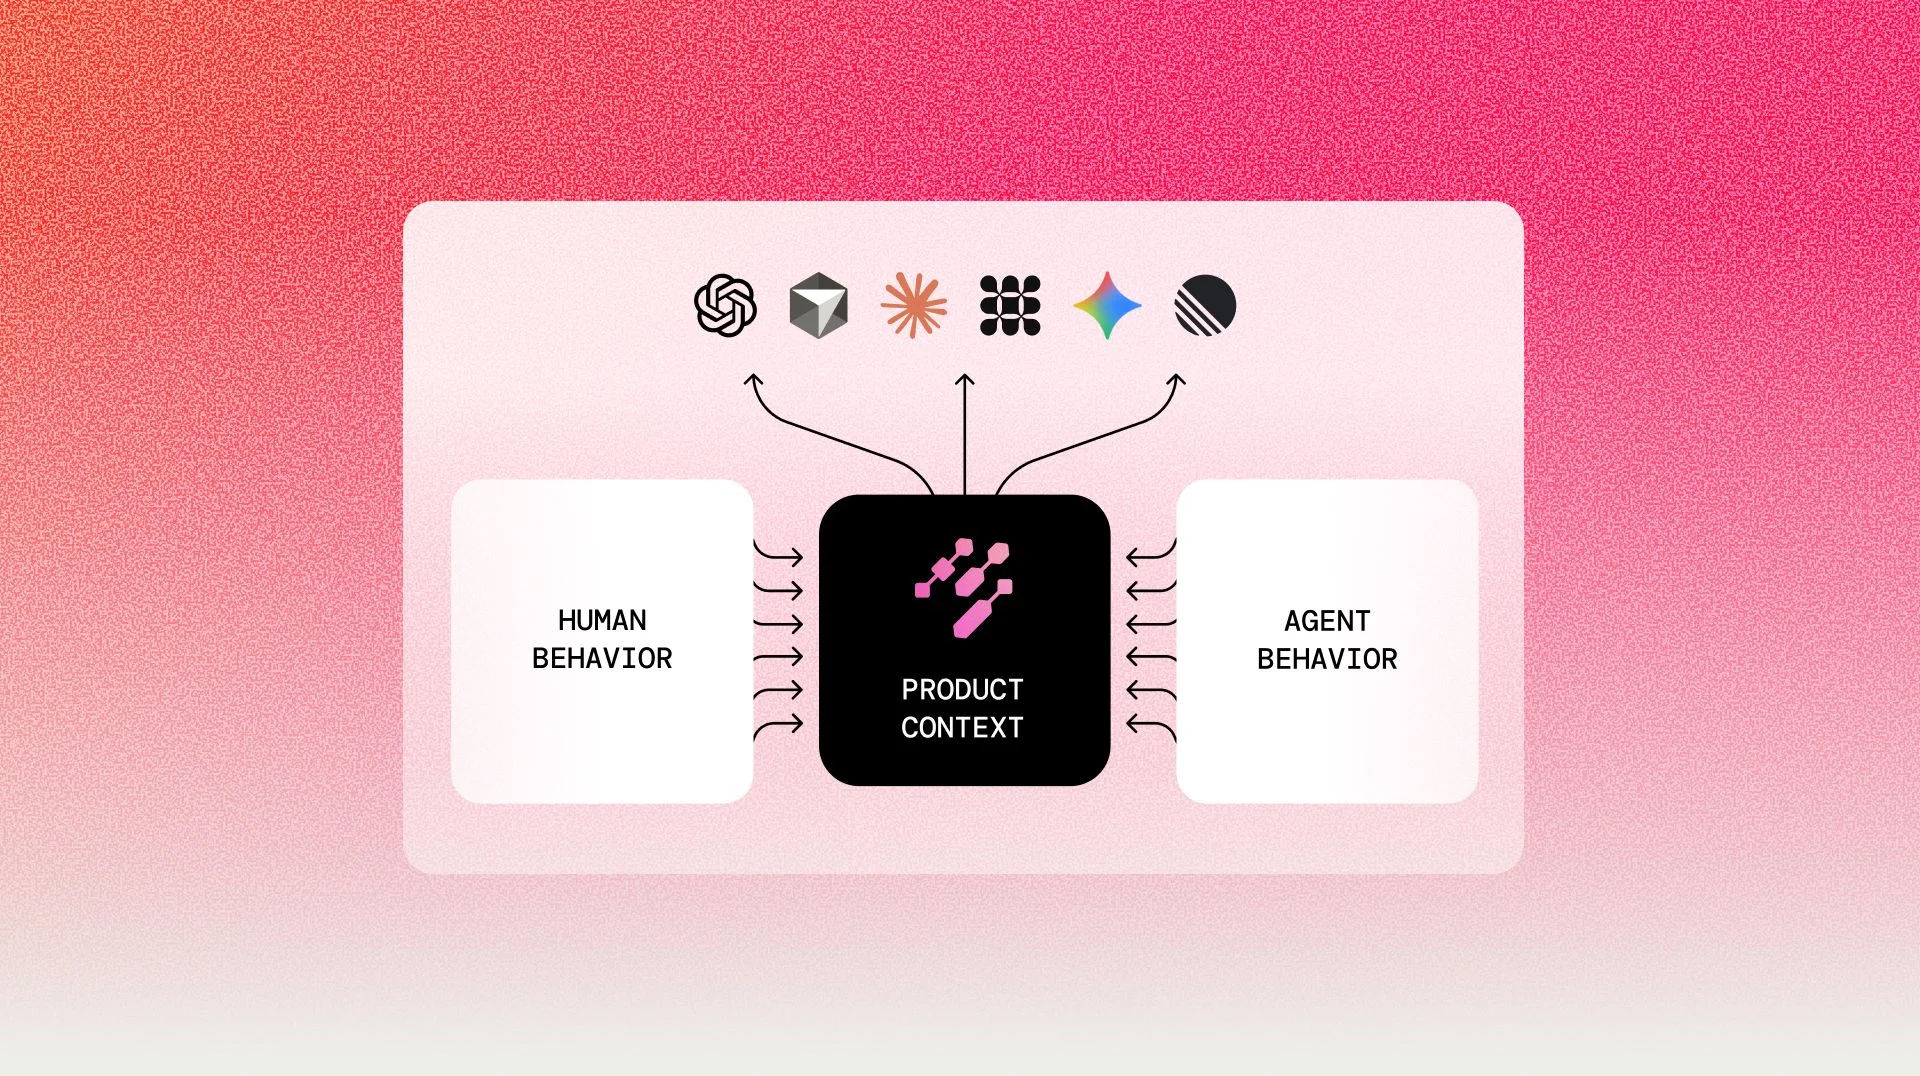
Agent Toolkit gibt jedem Agenten den Produkt- und Nutzerkontext, den Pendo bereits erfasst, und stellt ihn dem Agenten in Echtzeit bereit:
- Sitzungskontext: eine Echtzeit-Aufzeichnung dessen, was jemand in Ihrem Produkt getan hat, sodass der Agent diese Historie bereits kennt.
- Frustrations-Trigger: Rage-Klicks, tote Klicks, U-Turns und Fehler – direkt an den Agenten übermittelt, damit er eingreifen kann, bevor jemand ein Ticket öffnet.
- Workflow-Hinweise: erinnert jemanden genau daran, wo er aufgehört hat, wenn er einen bestimmten Prozess mittendrin abbricht.
- Guide-Anzeige: verweist auf genau die Anleitung, den Tipp oder das Tutorial, das das Problem löst, mit dem jemand nicht weiterkommt – anstatt dass der Agent es von Grund auf erklärt oder auf einen langen Hilfeartikel verweist.

Das ist die eigentliche Lösung für einen Zombie-Agenten. Kein besseres Modell. Kein längerer System-Prompt. Kontext. Es funktioniert, egal ob Ihr Agent ein Drittanbieter-Tool wie Fin, Sierra, Zendesk oder Decagon ist oder etwas, das Ihr Team von Grund auf entwickelt hat.
Teachable hat das aus erster Hand erlebt. Ihr Support-Agent, der auf Intercom's Fin basiert, wusste nicht, welche Seite ein Nutzer gerade verlassen hatte oder wie oft er auf denselben defekten Button geklickt hatte, bevor er einen Chat öffnete – ein klassischer Zombie-Agent. Sobald Pendo Fin diesen Kontext in Echtzeit übermittelte, konnte der Agent mit etwas Konkretem einsteigen: „Sieht aus, als hättest du beim Anpassen deiner Einstellungen auf Widerstand gestoßen. Was wolltest du ändern?"
Das Engagement bei proaktiven Nachrichten stieg um 200 %. 86 % dieser Gespräche wurden gelöst, ohne an einen Menschen eskaliert zu werden, bei einem CX-Score von 4 von 5 Sternen. Am besten: 91 % benötigten überhaupt keinen Menschen.
Erste Schritte mit Pendo for Agents: Weniger Zombie. Mehr Fürsprecher.
Heute vereint Pendo for Agents Agent Analytics und Agent Toolkit unter einem Dach – entwickelt, um jeden Agenten, ob selbst gebaut oder zugekauft, zum besten Fürsprecher des Kunden zu machen, statt zu einem weiteren Zombie im Stack. Agent Analytics beantwortet die Frage, ob ein Agent wirklich hilft. Agent Toolkit macht ihn besser im Helfen – noch bevor der Nutzer den Chat öffnet. Eine Hälfte beweist den Wert, die andere liefert ihn schneller.

Wenn Sie im Support oder in der IT tätig sind, hören Ihre Agenten damit auf, nur auf Tickets zu reagieren, und Ihr Team gewinnt Kapazitäten für die Gespräche, bei denen wirklich ein Mensch gefragt ist.
Wenn Sie die Roadmap verantworten, wissen Sie damit endlich, was Ihr Agent als Nächstes tun sollte.
Wenn Sie einen In-App-Assistenten, einen Kundensupport-Agenten oder etwas haben, das Ihr eigenes Team entwickelt hat, fordern Sie eine Demo an um zu sehen, was proaktive, kontextbewusste Gespräche mit Ihrer Lösungsrate machen.
Sie nutzen Pendo bereits? Verwenden Sie das Agent Toolkit kostenlos während der offenen Beta-Phase. Einfach Ihre Pendo-Plattform aufrufen und das Agent Toolkit aktivieren.