Die heutigen Kundensupport-Agenten sind äußerst leistungsfähig – Salesforce hat Fin gerade für 3 Milliarden Dollar gekauft, und der Markt wächst weiterhin rasant.
Aber diese Agenten sind nicht perfekt. Wenn sie scheitern, liegt es daran, dass sie Fragen beantworten, für die sie nicht trainiert wurden, keine Daten haben oder die sie nicht erwartet haben.
Wenn ein Nutzer einen Support-Chat öffnet und „Ich kann meinen Bericht nicht exportieren" eingibt, hört der Agent diesen Satz – sieht aber möglicherweise nicht, dass der Nutzer den Export-Vorgang in den letzten 20 Minuten dreimal versucht hat, jedes Mal am selben Schritt gescheitert ist und nun frustriert genug ist, um in Großbuchstaben zu schreiben. Also liefert er eine allgemeine Anleitung, die der Nutzer bereits ausprobiert hat, und ein Support-Ticket wird trotzdem eingereicht.
Die fehlende Verbindung zwischen dem, was ein Nutzer den Agenten mitteilt, und dem, was er in Ihrem Produkt getan hat, ist der Punkt, an dem die Ticket-Deflection zusammenbricht. Aber CS-Teams beginnen, diese Lücke mit verhaltensbasierten Erkenntnissen zu schließen.
Warum intelligente Agenten trotzdem Support-Tickets erzeugen
Die meisten KI-Agenten-Deployments starten mit demselben Setup: einer Wissensdatenbank, einer Chat-Oberfläche und der berechtigten Erwartung, dass beides zusammen die meisten Nutzerprobleme lösen wird. Bei einfachen, eindimensionalen Fragen funktioniert das gut.
Das Problem ist, dass die meisten Support-Interaktionen nicht einfach sind. Sie sind spezifisch. Ein Nutzer, der bei Schritt drei eines sechsstufigen Workflows feststeckt, braucht keine allgemeine Antwort über die Funktion. Er braucht Hilfe bei dem, was bei Schritt drei schiefgelaufen ist. Ein Agent ohne Verhaltenskontext kann diesen Unterschied nicht erkennen. Jeder Nutzer sieht gleich aus, und jede Frage wird behandelt, als wäre sie ohne Vorgeschichte eingegangen.
Warum das Ticket-Volumen nach dem Agenten-Deployment konstant bleibt
Deshalb können Sie einen wirklich leistungsfähigen KI-Agenten einsetzen und trotzdem sehen, dass das Ticket-Volumen stabil bleibt. Den Agenten fehlt schlicht die Informationsebene, die es ihnen ermöglichen würde, auf das zu reagieren, was tatsächlich passiert.
Warum das Ticket-Volumen nach dem Einsatz von Agenten gleich bleibt
Deshalb können Sie einen wirklich leistungsfähigen KI-Agenten einsetzen und trotzdem beobachten, dass das Ticket-Volumen konstant bleibt. Den Agenten fehlt schlicht die Informationsebene, die es ihnen ermöglichen würde, auf das zu reagieren, was tatsächlich passiert.
So sieht das in der Praxis aus:
- Ein Benutzer stößt in einem Workflow auf eine Hürde.
- Er öffnet den Agenten-Chat und beschreibt sein Problem in den allgemeinsten Begriffen, die ihm einfallen, weil er den technischen Namen für das, was schiefgelaufen ist, nicht kennt.
- Der Agent gleicht Schlüsselwörter ab, gibt eine Antwort zurück, die das allgemeine Thema behandelt, und verfehlt den eigentlichen Fehler vollständig.
- Der Benutzer probiert den Vorschlag aus, er hilft nicht, und er reicht ein Ticket ein.
Das Ticket hätte vermieden werden können, wenn Ihre Agenten das gehabt hätten, was sie brauchten, um es zu verhindern.
Verhaltenssignale: Der Kontext, der Agenten bisher gefehlt hat
Produktbezogene Verhaltensdaten geben Agenten das, was Wissensdatenbanken nicht können: Informationen darüber, was Nutzer in Ihrem Produkt tatsächlich getan haben, bevor Gespräche beginnen.
Die vier Signale, die zur Ticket-Deflection beitragen
Es gibt vier Kategorien, die am wichtigsten sind:
- Wiederholte Versuche teilen dem Agenten mit, dass ein Nutzer dieselbe Aktion mehrfach ohne Erfolg versucht hat. Das unterscheidet sich von einem Nutzer, der zum ersten Mal nach der Funktion fragt, und erfordert eine andere Antwort.
- Abbruchpunkt teilt dem Agenten genau mit, an welcher Stelle in einem Workflow ein Nutzer nicht weitergekommen ist – nicht nur, dass er feststeckt. Wenn ein Nutzer die Schritte eins bis vier abgeschlossen und bei Schritt fünf jedes Mal abgebrochen hat, liegt die Antwort bei Schritt fünf, nicht bei Schritt eins.
- Frustrationssignale, wie Rage-Clicks, wiederholte Eingaben und schnelles Hin-und-Her-Navigieren, zeigen an, dass die Geduld des Nutzers bereits erschöpft ist, bevor das Gespräch beginnt. Die erste Antwort muss sitzen. Es gibt keinen Spielraum für einen Fehler.
- Nutzerkontext teilt dem Agenten mit, ob er mit jemandem in seiner ersten Woche mit dem Produkt oder mit einem erfahrenen Nutzer spricht, der auf einen Grenzfall stößt. Ein neuer Nutzer benötigt Onboarding-Unterstützung. Ein erfahrener Nutzer braucht eine spezifische Lösung. Das sind unterschiedliche Gespräche.
Wie Kontext die Interaktionen mit Agenten verändert
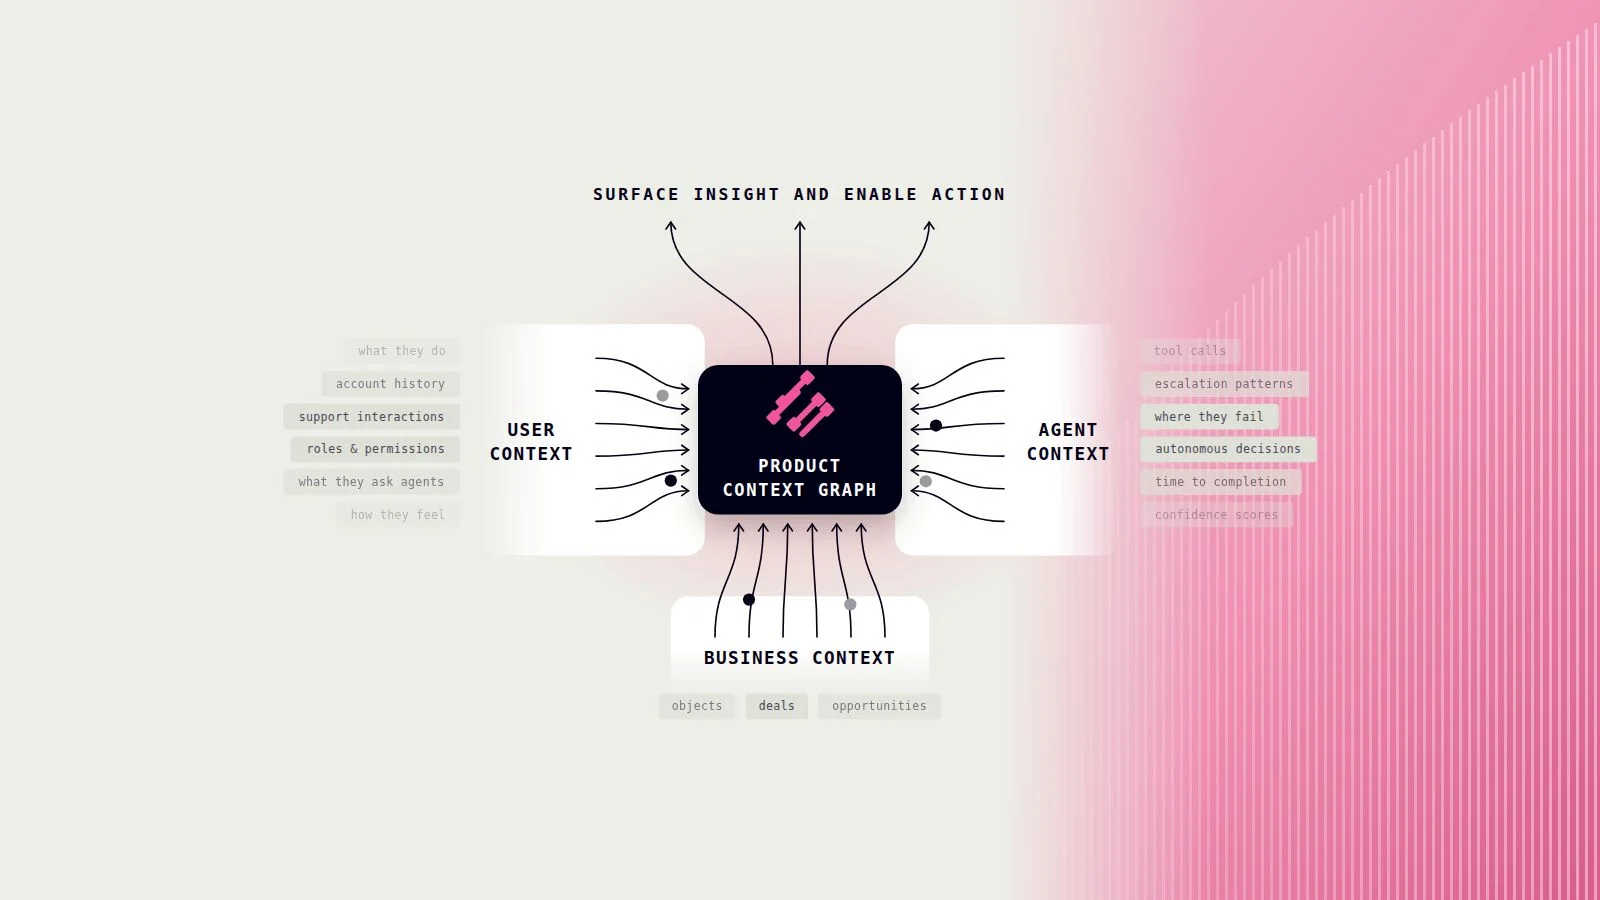
Wenn ein Agent vor Gesprächsbeginn Zugang zu diesen Signalen hat, versteht er die Situation bereits und kann direkt reagieren. Es geht darum, bessere Gespräche mit Agenten zu ermöglichen, um Tickets zu umgehen.
Pendo Agent Analytics erfasst und stellt diese Verhaltenssignale bereit und gibt Ihren Agenten die Kontextebene, die ihnen bisher gefehlt hat.
Agent-Observability: Die Kennzahlen, die zeigen, ob Deflection tatsächlich stattfindet
Sobald Verhaltensdaten Ihren Agenten informieren, benötigen Sie Transparenz darüber, ob sich das auszahlt – durch Agent-Observability.
Die Lösungsrate zeigt Ihnen, wie oft Agenten Gespräche ohne menschliche Übergabe abschließen, aber nicht, warum Agenten scheitern, wenn sie es tun. Dafür müssen Sie eine Ebene tiefer gehen.
Die Agent-Kennzahlen, die für IT-Leiter wichtig sind
- Rage-Prompt-Rate misst Prompts, die Schimpfwörter, Großbuchstaben oder wiederholte Anfragen enthalten. Eine hohe Rage-Prompt-Rate bedeutet, dass Benutzer bereits frustriert sind, bevor der Agent die Möglichkeit hat zu helfen. Wenn diese Zahl steigt, erzeugt etwas in der Erfahrung vor dem Gespräch Reibung, die der Agent dann übernimmt.
- Abbruchrate innerhalb der Agenten-Interaktion zeigt Ihnen, wo Benutzer abbrechen. Wenn Benutzer nach der zweiten Antwort des Agenten konsequent aussteigen, liegt das Problem bei der zweiten Antwort. Das ist ein trainierbares Problem, sobald Sie es sehen können – aber Sie müssen es erst sehen können.
- Aufgabenabschlussrate beantwortet die Frage, die die Lösungsrate überspringt: Hat der Benutzer tatsächlich das getan, wobei der Agent ihm geholfen hat? Ein Benutzer kann einen Chat schließen, ohne ein Ticket einzureichen, und sein Problem trotzdem nicht gelöst haben.
Diese Zahlen zeigen Ihnen, ob Ihre Agenten-Investition auf Budgetebene vertretbar ist.
Command Center gibt Ihnen den Portfolio-weiten Überblick darüber, wie jedes KI-Tool abschneidet, sodass Agent-Kennzahlen nicht in einem Silo leben. Sie verbinden sich mit dem größeren Bild dessen, was in Ihrem KI-Stack funktioniert.
KI-ROI in der Praxis: 86 % der Gespräche ohne menschliche Beteiligung gelöst
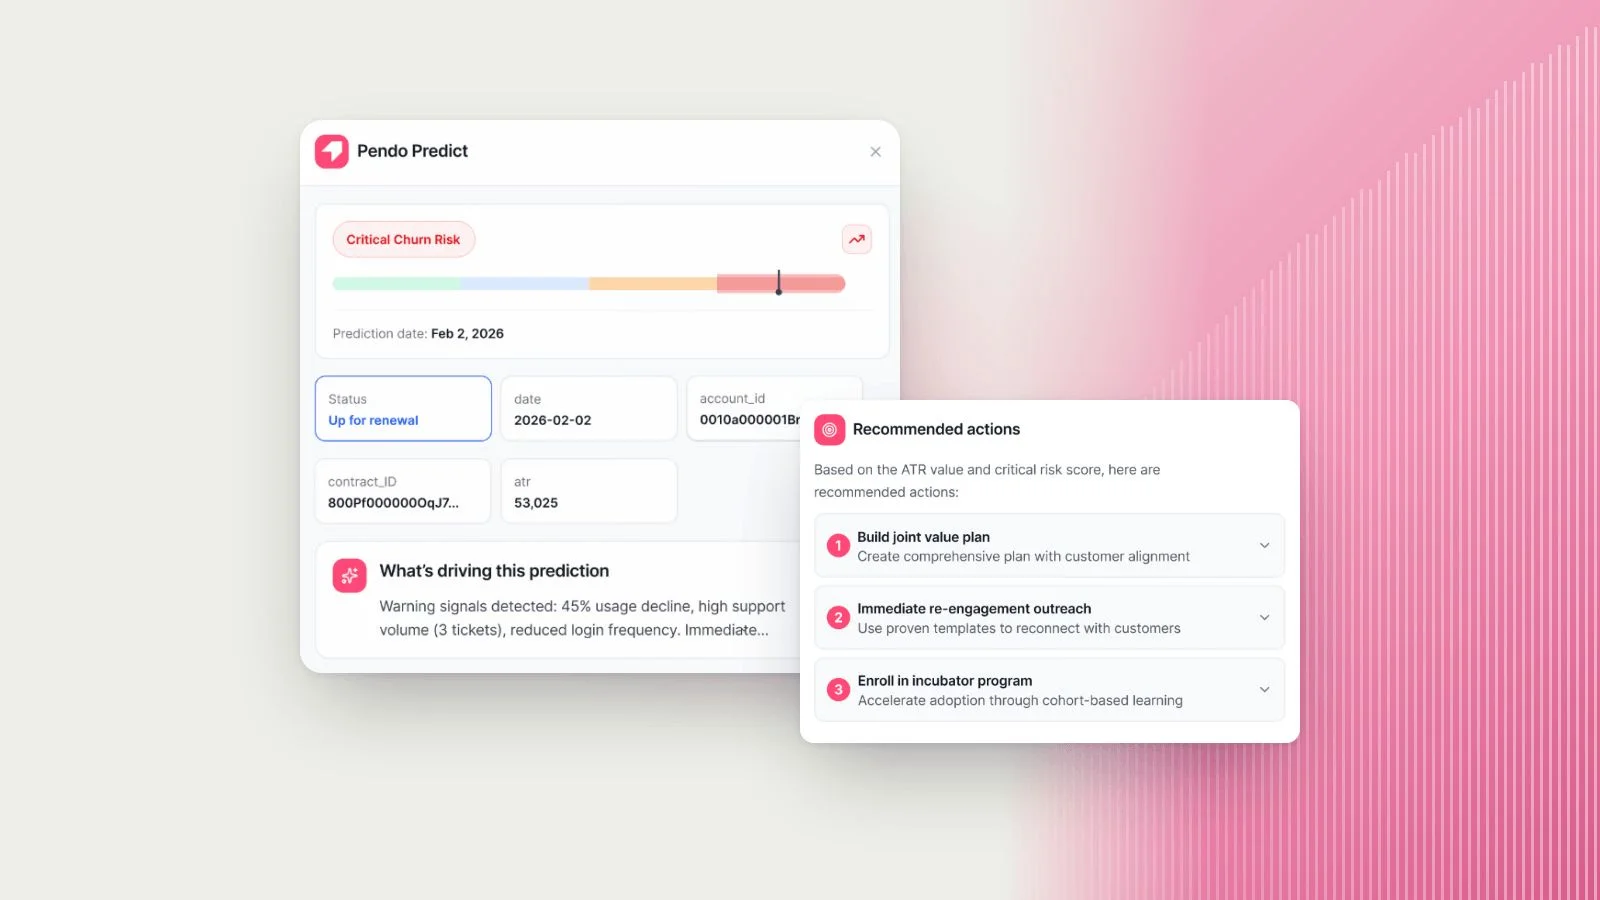
Ein Nutzer stößt in einem Workflow auf Hindernisse. Die Verhaltenssignale werden in Echtzeit erfasst. Wenn dieser Nutzer den Agent-Chat öffnet, verfügt der Agent bereits über Kontext: was der Nutzer getan hat, wo er nicht weiterkam und wie frustriert er wirkt. Die Antwort geht auf die konkrete Situation ein. Das Problem wird gelöst, bevor es zu einem Ticket wird.
Genau das hat Teachable mit Fin aufgebaut, unterstützt durch Pendo-Daten:
„Da Fin durch Pendo-Daten unterstützt wird, erreicht es Kunden in entscheidenden Momenten und löst eingehende Fragen, bevor sie zu Support-Tickets werden. Wir sehen bereits, dass Fin 86 % der Gespräche löst, ohne einen Menschen einzubeziehen – und das bei einem CX-Score von 4/5 Sternen."
— Kathleen Ross, Product Support Associate Director, Teachable
Warum das eine Geschäftskennzahl ist, keine Support-Kennzahl
Jedes Gespräch, das Fin ohne menschliche Übergabe löst, ist ein messbarer vermiedener Kostenpunkt. Dabei einen CX-Score von 4/5 zu halten bedeutet, dass die Qualität nicht zugunsten der Zahl gesunken ist. Der Agent liest den tatsächlichen Kontext, sodass er nicht raten muss.
Der Verbesserungskreislauf: Wie Deflection im Laufe der Zeit besser wird
Die anfängliche Bereitstellung ist nur ein Teil davon. Verhaltensdaten rüsten den Agent vor einem Gespräch aus und zeigen Ihnen danach, was zu verbessern ist. Wenn Rage-Prompts an derselben Stelle wiederholt zu einem Anstieg oder einem Abbruch führen, passen Sie die Antwort des Agents an, trainieren ihn gezielt auf den spezifischen Fehler oder leiten die Workflow-Lücke an das Produktteam weiter. Deflection verbessert sich, weil die Feedback-Schleife kontinuierlich ist – nicht weil die Konfiguration von Anfang an richtig war.
Verhaltensdaten sind das, was Deflection tatsächlich ermöglicht
Die meisten KI-Agenten werden mit guten Absichten eingesetzt und liefern aus einem behebbaren Grund unterdurchschnittliche Ergebnisse: Ihnen fehlt der Kontext. Produktbezogene Verhaltensdaten sind dieser Kontext. Sie rüsten Agenten aus, bevor das Gespräch beginnt, zeigen auf, wo sie versagen, und geben IT-Verantwortlichen die Transparenz, um zu belegen, dass die Investition sich lohnt.
Die 86 % sind einfache Wissenschaft: Agenten, die wissen, was Nutzer getan haben, lösen mehr als Agenten, die nur wissen, was Nutzer gerade sagen.